Dari apa yang saya pelajari, Analisis regresi ada 2 macam, yaitu: Linear Regression dan Logistic Regression.
Dari beberapa situs, saya mengumpulkan informasi seputar Regresi Linier. Dalam situs http://www.produksielektronik.com, saya mendapatkan informasi tentang perhitungan Regresi Linier menggunakan MS-Excel.
Baca Selengkapnya...
Friday, February 20, 2015
Analisis Regression

Logistic Regression
Catatan Logistic Regression ini saya ambil dari banyak situs, semoga informasinya bermanfaat bagi siapa saja yang ingin belajar.
Dari situs : https://teorionline.wordpress.com saya mendapat beberapa informasi tentang Logistic Regression.
Regresi logistic merupakan salah satu analisi multivariate, yang berguna
untuk memprediksi dependent variabel berdasarkan variabel independen.

bercanda aja...
Baca Selengkapnya...
Tuesday, February 11, 2014
Clustering
Informasi ini diperoleh dari banyak situs berikut ini:
http://www.mathworks.com/help/fuzzy/fuzzy-clustering.html#FP43419
http://yudiagusta.wordpress.com/clustering/
Data clustering atau pengelompokan data merupakan bagian dari data mining, yang tujuannya adalah mengelompokan data yang sama kedalam suatu kelompok dan data yang berbeda kedalam kelompok lainnya. Ada banyak metode dalam data clustering yang pada dasarnya dapat dikelompokan menjadi 3 macam, yaitu:
1. Pengelompokan secara partisi (partition-based clustering)
2. Pengelompokan secara hirarki (hierarchical clustering)
3. Pengelompokan secara Automatic Mapping
Partition-based Clustering
merupakan pengelompokan data yang memilah-milah dan menganalisa data ke dalam cluster-cluster yang ada. Beberapa metode clustering dengan cara partisi ini adalah:
K-Means
Baca Selengkapnya...
Wednesday, February 5, 2014
Metode Fuzzy C-Means
Tulisan ini saya buat sebagai media belajar bagi saya pribadi dan siapa saja yang mau belajar tentang Fuzzy C-Means. Diambil dari berbagai sumber.
http://informatika.web.id/metode-fuzzy-c-means-clustering.htm
http://sariberbagiilmu.blogspot.com/2011/05/fuzzy-c-means.html
Fuzzy C-means Clustering (FCM), atau dikenal juga sebagai Fuzzy ISODATA,
merupakan salah satu metode clustering yang merupakan bagian dari
metode Hard K-Means. FCM menggunakan model pengelompokan fuzzy sehingga
data dapat menjadi anggota dari semua kelas atau cluster terbentuk
dengan derajat atau tingkat keanggotaan yang berbeda antara 0 hingga 1.
Tingkat keberadaan data dalam suatu kelas atau cluster ditentukan oleh derajat keanggotaannya. Metode Fuzzy C-Means Clustering pertama kali dikenalkan oleh Jim Bezdek pada tahun 1981 (Jain dkk, 1999). Fuzzy C-Means adalah salah satu teknik pengelompokkan data yang mana keberadaan tiap titik data dalam suatu kelompok (cluster)ditentukan oleh derajat keanggotan. Metode Fuzzy C-Means termasuk metode supervised clustering dimana jumlah pusat cluster ditentukan di dalam proses clustering.
Berdasarkan situs informatika.wed.id, algoritma dari fuzzy c-means adalah sebagai berikut (Yan, 1994) :
Input Data
Input data yang akan dikelompokkan, yaituX, berupa matrix berukuran n x m (n=jumlah sampel data, m=atribut setiap data). Xij data sampel ke-i (i=1,2,…n), atribut ke-j (j=1,2,..m).
Tentukan Jumlah Cluster
Tentukan jumlah cluster (c), pangkat untuk matriks partisi
(w), maksimum iterasi (MaxIter), error terkecil yang diharapkan (ξ),
fungsi objektif awal (Po=0), dan iterasi awal (t=1).
Bangkitkan Nilai Random
Bangkitkan bilangan random ηik, i=1,2,…n; k=1,2,…c sebagai elemen matrik partisi awal U.
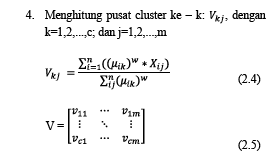
Hitung Pusat Cluster ke-k
Hitung pusat cluster ke-k: , dengan k=1,2,…,c; dan j=1,2,…,m, menggunakan persamaan berikut (Yan, 1994) :

dengan :
Vkj = pusat cluster ke-k untuk atribut ke-j
ηik = derajat keanggotaan untuk data sampel ke-i pada cluster ke-k
xij = data ke-i, atribut ke-j
Hitung Fungsi Objektif
Hitung fungsi objektif pada iterasi ke-t menggunakan persamaan berikut (Yan, 1994) :

Dengan I = 1,2,…,n; dan k=1,2,…c.
Dimana :
Vkj = pusat cluster ke-k untuk atribut ke-j
ηik = derajat keanggotaan untuk data sampel ke-i pada cluster ke-k
xij = data ke-i, atribut ke-j
Cek kondisi berhenti
jika:


Berdasarkan situs sariberbagiilmu.blogspot.com: Konsep dasar FCM, pertama kali adalah menentukan pusat cluster yang akan menandai lokasi rata-rata untuk tiap-tiap cluster. Pada kondisi awal, pusat cluster ini masih belum akurat. Tiap-tiap data memiliki derajat keanggotaan untuk tiap-tiap cluster. Dengan cara memperbaiki pusat cluster dan nilai keanggotaan tiap-tiap data secara berulang, maka dapat dilihat bahwa pusat cluster akan menujui lokasi yang tepat. Perulangan ini didasarkan pada minimasi fungsi obyektif (Gelley, 2000) yang menggambarkan jarak dari titik data yang diberikan ke pusat cluster yang terbobot oleh derajat keanggotaan titik data tersebut. Algoritma yang digunakan pada metode Fuzzy C-means adalah sebagai berikut:


Baca Selengkapnya...
Monday, November 18, 2013
Bagaimana Menghitung Hyperplane pada SVM?
SVM atau dikenal dengan Support Vector Machine merupakan salah satu metode klasifikasi yang ditemukan oleh Vapnik tahun 1979 1. Dasar pemikiran metode SVM ini adalah: 2
1. Garis hyperplane yang optimal yang memisahkan pola secara linier.
2. Pemisahan pola yang non-linier menggunakan penambahan fungsi kernel.

Secara matematika, formulasi problem optimisasi SVM untuk kasus klasifikasi linier di dalam primal space adalah:3

Berikut saya tambahkan sedikit perhitungan SVM ala MS-Excel:
 |
| Perhitungan MS-Excel menghitung Hyperplane |
1. CHRISTOPHER J.C. BURGES, Data Mining and Knowledge Discovery, 1998 Kluwer Academic Publishers, Boston.
2. R. BERWICK, An Idiot’s guide to Support vector machines (SVMs), www.cs.ucf.edu/courses/cap6412/fall2009/papers/Berwick2003.pdf, 28 October 2013.
3. Budi Santosa, Tutorial Support Vector Machine, Teknik Industri, ITS.
Baca Selengkapnya...
Wednesday, November 6, 2013
Jaringan Komputer II
Jaringan komputer dapat dibedakan berdasarkan luas areanya, yaitu:
- PAN (Personal Area Network)
- LAN (Local Area Network)
- MAN (Metropolitan Area Network)
- WAN (Wide Area Network)

Media yang digunakan dalam jaringan PAN dapat berupa kabel USB dengan USB port, Bluetooth, Infrared atau Wi-Fi.
Jaringan komputer LAN (Local Area Network) lebih besar dibandingkan jaringan PAN. LAN dapat mencakup area hingga 20 KM, misalnya jaringan lokal dalam 1 gedung, 1 kampus atau 1 perkantoran.>
Jaringan komputer LAN dapat digambarkan sebagai berikut:

Media yang dapat digunakan dalam jaringan LAN adalah kabel, seperti UTP atau fiber optic, dan non kabel, seperti Wi-Fi (gelombang radio).
Jaringan komputer MAN (Metropolitan Area Network) memiliki luas jangkauan yang lebih besar dari jaringan LAN, dapat mencapai 50 KM. Jaringan ini merupakan gabungan dari jaringan LAN, contoh jaringan antar gedung dalam suatu kampus atau jaringan antar kantor cabang suatu perusahaan dalam satu kota.
Jaringan MAN ini dapat digambarkan sebagai berikut:

Media yang digunakan dalam jaringan MAN pada dasarnya sama dengan yang digunakan pada tipe jaringan WAN (Wide Area Network), yaitu menggunakan MODEM dan jaringan telekomunikasi.
Jaringan WAN (Wide Area Network) disebut juga jaringan global yang melingkupi seluruh jaringan komputer yang ada di muka bumi.

Cara yang digunakan untuk menghantar data dari satu komputer ke komputer lain atau dari satu jaringan ke jaringan lain adalah dengan menggunakan media transmisi.
Ada beberapa macam media transmisi, yaitu:
Media transmisi Kabel:
- Twisted Pair Cable, yang terdiri dari 2 macam, yaitu Shielded Twisted Pair (STP) dan Unshielded Twisted Pair (UTP).
- Coaxial Cable, yang terdirid ari 2 macam, yaitu Thin Coaxial Cable yang berdiameter 5 mm dan Thick Coaxial Cable yang berdiameter 12 mm.
- Fiber Optic, yang terdiri dari 3 macam, yaitu Singlemode Step Index, Multimode Step Index dan Multimode Graded Index.
Media transmisi Non-Kabel:
- Infra red, digunakan untuk komunikasi jarak dekat.
- Gelombangradio frekuensi tinggi atau gelombang mikro (microwave), yang terdiri dari UHF (Ultra High Frequency: 300MHz - 3GHz), SHF (Super High Frequency: 3GHz - 30GHz) dan EHF (Extremely High Frequency: 30GHz - 300GHz).
- Satelit, digunakan untuk menerima sinyal dari 1 stasiun bumi dan meneruskan sinyal ke stasiun bumi lainnya.
Baca Selengkapnya...
Tuesday, November 5, 2013
Topologi Jaringan Komputer
Topologi jaringan adalah suatu aturan atau cara untuk menghubungkan komputer yang satu dengan komputer yang lainnya sehingga membentuk suatu jaringan.
Ada beberapa jenis topologi, yaitu:
- BUS
- RING
- STAR
- TREE
- MESH
- Biaya
- Kecepatan
- Lingkungan
- Ukuran
- Konektivitas

Topologi Bus

Topologi Mesh

Topologi Ring

Topologi Star

Topologi Tree
Sunday, November 3, 2013
The Way in Which ICT is used
Modelling Application
A simulation is the creation of a model of a real system in order to study the behaviour of the system. The model is computer generated and is based on mathematical representation.The advantages / the benefits / the reason of using computer as simulation:
- Less expensive.
- It is saver to run a simulation than the real one.
- It is nearly impossible to try out some tasks in real life because of the high risk.
- With simulation, various scenarios can be tried out in advance.
- It is faster to do a simulation than the real thing
- Only as good as the data used (not representing the real-life situation).
- It can be very expensive to set up.
- It often requires specialist software.
- It frequently requires very fast processors/computer system.
Monitoring Application
In monitoring applications, the computer simply reviews the data from the sensors (by comparing it to data stored in memory) and updates its files and / or gives a warning signal if the values are outside given parameters.Examples:
- monitoring a patient's vital signs in a hospital.
- monitoring a scientific experiment in a laboratory.
- a burglar alarm system
- environmental monitoring (e.g. oxygen levels in a river)
- the computer will not forget to take reading.
- the reading will tend to be more accurate
- the computer's response time is much faster.
- it is done automatically.
- it can work 24 hours every day (24/7).
- Sensor read key vital signs.
- The data from the sensors is converted into digital using an ADC.
- The data is stored in computer's memory.
- The computer compares the data from sensors with the value stored in its memory.
- The results are output on a screen in the form of graphs and / or digital read-outs.
- An alarm is activated if any of the data is outside acceptable parameters.
- The system continues to monitor the patient until the computer is turned off.
Controlling Application
In control application, the computer again reviews the data from sensors (by comparing it to data stored in memory). But if the values are outside the given parameters it takes action to try and get the value within acceptable ranges.Examples:
- controlling a chemical process.
- controlling a nuclear reactor.
- controlling a greenhouse environment.
- controlling a central heating system.
- controlling a set of traffic lights.
- The response time is much faster.
- It is safer, as some processes are dangerous, so it is better to control it from a distance.
- Another common advantages of using computer like more accurate, can work 24/7 or more reliable.
There are five different sensors could be used to control a greenhouse environment: humidity, moisture, temperature, pH and light sensors. The following process is based on humidity sensor.
- The humidity sensor sends a signal to an ADC.
- The ADC sends a digital signal to the computer.
- This compares the input with stored values and decides what action needs to be taken.
- If humidity is too high, the computer sends a signal to a DAC to operate the motors to open windows thus reducing the humidity.
- If it is too low, the computer sends a signal to open valves to spray water into the air.
Jaringan Komputer I
Jaringan komputer merupakan sekumpulan komputer beserta pirantinya yang terhubung satu dengan lainnya dan dapat saling berkomunikasi atau bertukar data.
Tipe-tipe jaringan komputer dapat dibedakan berdasarkan:
- Luas area jangkauannya, contoh: PAN (Personal Area Network), LAN (Local ARea Network), MAN (Metropolitas Area Network) dan WAN (Wide Area Network). Penjelasan lebih lanjut click disini.
- Topologinya, contoh: BUS, RING, STAR, TREE, HIERARCHICAL, MESH.
- Medianya, contoh: Wired Network (jaringan dengan kabel) dan Wireless Network (jaringan tanpa kabel)
Internet merupakan jaringan global, dari situs wikipedia, istilah internet adalah kependekan dari internetwork. Jika kita mencari kepanjangan dari istilah internet maka ada juga yang memanjangkan istilah internet menjadi "International computer network" atau"International networking" bahkan ada juga "INdomie TEluR korNET". Pada situs ini saya mengacu pada situs Wikipedia saja dengan menggunakan istilah Internetwork.
Jadi Internet ini merupakan jaringan global yang menghubungkan komputer-komputer dan jaringan-jaringan komputer yang ada di dunia. Sama seperti yang dituliskan pada situs Webopedia yang mengatakan Internet sebagai "a global network connecting millions of computers"
Fungsi utama dari jaringan komputer adalah pemakaian bersama baik hardware maupun software. Di dalam jaringan komputer, kita mengenal 2 jenis komputer, yaitu Server dan Client. Server merupakan komputer yang menyediakan akses untuk para pengguna jaringan, contoh: penyediaan program atau data dan tempat menyimpan data.
Client merupakan komputer yang digunakan oleh user dalam jaringan yang mengambil data dari server atau menggunakan program dari server.
Aplikasi jaringan komputer ini antara lain:
- aplikasi komunikasi dan transfer data (contoh: net support school)
- electronic mail (e-mail)
- electronic conference
- voice over internet protocol (voip)
- chatting
- file transfer protocol
- web
Wednesday, May 1, 2013
Augmented Reality
Catatan mengenai Augmented Reality:
diambil dari Wikipedia

Realitas
tertambah, atau kadang dikenal dengan singkatan bahasa Inggrisnya AR (augmented
reality), adalah teknologi yang menggabungkan benda maya dua dimensi dan
ataupun tiga dimensi ke dalam sebuah lingkungan nyata tiga dimensi lalu
memproyeksikan benda-benda maya tersebut dalam waktu nyata. Tidak seperti
realitas maya yang sepenuhnya menggantikan kenyataan, realitas tertambah
sekedar menambahkan atau melengkapi kenyataan.
Benda-benda
maya menampilkan informasi yang tidak dapat diterima oleh pengguna dengan
inderanya sendiri. Hal ini membuat realitas tertambah sesuai sebagai alat untuk
membantu persepsi dan interaksi penggunanya dengan dunia nyata. Informasi yang
ditampilkan oleh benda maya membantu pengguna melaksanakan kegiatan-kegiatan
dalam dunia nyata.
Realitas
tertambah dapat diaplikasikan untuk semua indera, termasuk pendengaran,
sentuhan, dan penciuman. Selain digunakan dalam bidang-bidang seperti
kesehatan, militer, industri manufaktur, realitas tertambah juga telah
diaplikasikan dalam perangkat-perangkat yang digunakan orang banyak, seperti
pada telepon genggam.
Baca Selengkapnya...
Tuesday, March 26, 2013
Sistem Pendukung Keputusan
Konsep sistem pendukung keputusan (SPK) atau Decision support system (DSS) pertama kali diungkapkan pada awal tahun 1970-an oleh Michael S. Scott Morton dengan istilah Management Decision Sistem. Sistem tersebut adalah suatu sistem yang berbasis komputer yang ditujukan untuk membantu pengambil keputusan dengan memanfaatkan data dan model tertentu untuk memecahkan berbagai persoalan yang tidak terstruktur.
Istilah SPK mengacu pada suatu sistem yang memanfaatkan dukungan komputer dalam proses pengambilan keputusan. Untuk memberikan pengertian yang lebih mendalam, akan diuraikan beberapa difinisi mengenai SPK yang dikembangkan oleh beberapa ahli, diantaranya oleh Man dan Watson yang memberikan definisi sebagai berikut, SPK merupakan suatu sistem yang interaktif, yang membantu pengambil keputusan melalui penggunaan data dan model-model keputusan untuk memecahkan masalah yang sifatnya semi terstruktur maupun yang tidak terstruktur.
Pengambilan keputusan merupakan proses pemilihan alternative tindakan untuk mencapai tujuan atau sasaran tertentu. Pengambilan keputusan dilakukan dengan pendekatan sistematis terhadap permasalahan melalui proses pengumpulan data menjadi informasi serta ditambah dengan faktor – faktor yang perlu dipertimbangkan dalam pengambilan keputusan.
Tahap – tahap Pengambilan Keputusan
Menurut Herbert A. Simon ( Kadarsah, 2002:15-16 ), tahap – tahap yang harus dilalui dalam proses pengambilan
keputusan sebagai berikut :
1. Tahap Pemahaman ( Intelligence Phase )
Tahap ini merupakan proses penelusuran dan pendeteksian dari lingkup problematika serta proses pengenalan masalah. Data masukan diperoleh, diproses dan diuji dalam rangka mengidentifikasikan masalah.
2. Tahap Perancangan ( Design Phase )
Tahap ini merupakan proses pengembangan dan pencarian alternatif tindakan / solusi yang dapat diambil. Tersebut merupakan representasi kejadian nyata yang disederhanakan, sehingga diperlukan proses validasi dan verifikasi untuk mengetahui keakuratan model dalam meneliti masalah yang ada.
3. Tahap Pemilihan ( Choice Phase )
Tahap ini dilakukan pemilihan terhadap diantara berbagai alternatif solusi yang dimunculkan pada tahap perencanaan agar ditentukan / dengan memperhatikan kriteria – kriteria berdasarkan tujuan yang akan dicapai.
4. Tahap Impelementasi ( Implementation Phase )
Tahap ini dilakukan penerapan terhadap rancangan sistem yang telah dibuat pada tahap perancanagan serta pelaksanaan alternatif tindakan yang telah dipilih pada tahap pemilihan.
Jenis Keputusan
Keputusan – keputusan yang dibuat pada dasarnya dikelompokkan dalam 2 jenis, antara lain ( Herbert A. Simon ) :
1. Keputusan Terprogram
Keputusan ini bersifat berulang dan rutin, sedemikian hingga suatu prosedur pasti telah dibuat menanganinya sehingga keputusan tersebut tidak perlu diperlakukan de novo (sebagai sesuatu yang baru) tiap kali terjadi.
2. Keputusan Tak Terprogram
Keputusan ini bersifat baru, tidak terstruktur dan jarang konsekuen. Tidak ada metode yang pasti untuk menangani masalah ini karena belum ada sebelumnya atau karena sifat dan struktur persisnya tak terlihat atau rumit atau karena begitu pentingnya sehingga memerlukan perlakuan yang sangat khusus.
SISTEM PENDUKUNG KEPUTUSAN
Sistem Pendukung Keputusan merupakan suatu sistem interaktif yang mendukung keputusan dalam proses pengambilan keputusan melalui alternatif – alternatif yang diperoleh dari hasil pengolahan data, informasi dan rancangan model.
Pengertian Sistem Pendukung Keputusan
Menurut Keen dan Scoot Morton :
“ Sistem Pendukung Keputusan merupakan penggabungan sumber – sumber kecerdasan individu dengan kemampuan komponen untuk memperbaiki kualitas keputusan. Sistem Pendukung Keputusan juga merupakan sistem informasi berbasis komputer untuk manajemen pengambilan keputusan yang menangani masalah – masalah semi struktur “
Dengan pengertian diatas dapat dijelaskan bahwa sistem pendukung keputusan bukan merupakan alat pengambilan keputusan, melainkan merupakan sistem yang membantu pengambil keputusan dengan melengkapi mereka dengan informasi dari data yang telah diolah dengan relevan dan diperlukan untuk membuat keputusan tentang suatu masalah dengan lebih
cepat dan akurat. Sehingga sistem ini tidak dimaksudkan untuk menggantikan pengambilan keputusan dalam proses pembuatan keputusan.
Karakteristik Sistem Pendukung Keputusan
Dari pengertian Sistem Pendukung Keputusan maka dapat ditentukan karakteristik antara lain :
1. Mendukung proses pengambilan keputusan, menitik beratkan pada management by perception
2. Adanya interface manusia / mesin dimana manusia (user) tetap memegang control process pengambilan keputusan
3. Mendukung pengambilan keputusan untuk membahas masalah terstruktur, semi terstruktur dan tak struktur
4. Memiliki kapasitas dialog untuk memperoleh informasi sesuai dengan kebutuhan
5. Memiliki subsistem – subsistem yang terintegrasi sedemikian rupa sehingga dapat berfungsi sebagai kesatuan item
6. Membutuhkan struktur data komprehensif yang dapat melayani kebutuhan informasi seluruh tingkatan manajemen
Komponen Penyusun Sistem Pendukung Keputusan
Suatu Sistem Pendukung Keputusan (SPK) memiliki tiga subsistem utama yang menentukan kapabilitas teknis sistem pendukung keputusan, antara lain :
1. Subsistem Manajemen Basis data
2. Subsistem Manajemen Basis Model
3. Subsistem Dialog
Baca Selengkapnya...
Sunday, December 2, 2012
Metode Clustering: K-means
Pengantar
Dalam artikel sebelumnya, telah dibahas perbedaan clustering dan classification. Dalam artikel ini, kita akan membahas salah satu metode clustering yang paling dasar, yaitu K-means Clustering.
Apa itu K-means?
Sebelum kita melangkah lebih jauh, mungkin ada baiknya mengetahui latar belakang mengapa disebut K-means. K di sini dimaksudkan sebagai konstanta jumlah cluster yang diinginkan. Jadi, berhubung kita sudah mengasumsikan jumlah cluster yang akan dihasilkan algoritma ini, maka K didefiniskan diawal (contoh: K = 5 cluster).
Means dalam hal ini berarti nilai suatu rata-rata dari suatu grup data yang dalam hal ini didefinisikan sebagai cluster.
Jika
kita menggabungkan kedua hal tersebut, maka dapat diartikan bahwa
algoritma ini menggunakan K nilai rata-rata yang setiap nilai
rata-ratanya dihitung dari suatu cluster. Kalau ada 5 cluster, maka akan ada 5 rata-rata yang dipakai oleh algoritma ini.
Model Matematik
Seperti yang kita tau bahwa metode K-means ini menggunakan nilai rata-rata yang diambil dari setiap cluster. Maka berikut adalah cara bagaimana K-means menghitung rata-rata dari setiap cluster

Ck adalah nilai rata-rata dari cluster K (contoh: C1 adalah nilai rata-rata dari cluster yang pertama).  adalah semua anggota dari cluster K.
 adalah semua anggota dari cluster K.
Pertanyaaan
berikutnya adalah, bagaimana cara memilih anggota dari suatu cluster?
Cara memilihnya mudah. Andaikan ada suatu data, kita ingin mengetahui ke
dalam anggota cluster manakah data tersebut paling cocok dimasukkan.
Caranya adalah dengan menghitung selisih antara data dan setiap nilai
rata-rata cluster. Cluster yang nilai rata-ratanya yang
memiliki selisih terkecil dengan data tersebut merupakan cluster dimana
data tersebut dikategorisasikan. Secara matematis dapat didefinisikan
sebagai berikut.

X adalah data yang sedang kita tentukan ke cluster mana harus dimasukkan. Ck adalah nilai rata-rata dari cluster k. K adalah jumlah cluster. Jadi, Cluster T merupakan cluster yang paling cocok untuk data X, karena cluster T memiliki selisih terkecil.
Bagaimana cara menghitung selisih? Kita bisa menggunakan berbagai macam metode seperti Eucledian distance, Mahalanobis distance, Manhattan distance, Normalised Cosines distance. Metode yang paling populer adalah dengan menggunakan Eucledian distance.
Kita sudah mengetahui bagaimana algoritma menghitung mean dari
masing-masing cluster, dan bagaimana algoritma mengelompokan data ke
dalam cluster-cluster yang ada. Pertanyaan berikutnya adalah, ketika
pertama kali algoritma dijalankan, kita hanya punyai adalah jumlah
cluster yang akan dihasilkan (K). Nah! untuk menghitung nilai rata-rata
dari setiap cluster diperlukan anggota, dan untuk menentukan anggota,
kita memakai informasi nilai rata-rata. Ini mirip dengan masalah ayam
dan telur, yang mana yang lebih dahulu. Untuk mengatasinya, kita akan
menentukan terlebih dahulu nilai rata-rata dari setiap cluster. Bagaimana caranya? Ada banyak cara, untuk artikel singkat ini, kita akan menentukannya secara acak (random). Tentunya
dalam menentukan angka acak kita tidak sembarangan sebab ini akan
membuat algoritma tidak berjalan dengan baik. Cara yang paling mudah
adalah memilih data yang ada sebagai nilai rata-rata dari suatu cluster.
Sebagai contoh, misalkan ada 3 data yaitu (1,0), (1,2), (1,4). K kita
tentukan K = 2. Jadi ada dua nilai rata-rata yang perlu kita tentukan
diawal. Secara acak kita memilih C1 = (1,0) dan C2 = (1,4).
Setelah kita menentukan nilai rata-rata awal dari setiap cluster, selanjutnya algoritma akan meng-update keanggotaan dari setiap cluster. Setelah itu algoritma akan menghitung kembali nilai rata-rata dari setiap cluster berdasarkan anggotanya yang baru saja di-update.
Pertanyaan berikutnya, kapan berhenti? Algoritma akan berhenti ketika tidak ada perubahan keanggotaan dari setiap cluster.
Algoritma
Baik, sekarang kita akan melihat algoritma K-means clustering ini.
- Tentukan K
- Tentukan Ck untuk semua cluster dengan memilih secara acak (random) dari data yang ada
- Update keanggotaan dari setiap cluster
- Update Ck berdasarkan anggota yang baru saja di-update
- Lakukan langkah 3 dan 4, sampai tidak ada perubahan keanggotaan dari setiap cluster.
Mudah bukan?
Mungkin
ada beberapa dari anda bertanya mengapa algoritma ini benar? Dalam
konteks pertanyaan ini, yang ditanyakan adalah apakah algoritma ini
selalu konvergen atau dalam arti, apakah algoritma ini dapat selalu
berhenti, atau akan berjalan terus. Jawaban nya adalah hampir dapat
dipastikan algoritma ini dapat konvergen atau dapat dapat berhenti,
dengan beberapa catatan. Untuk para pembaca yang tertarik untuk
mengetahui lebih jauh sifat konvergensi dari K-means, dapat meneliti
lebih jauh dengan mencari literature yang berhubungan dengan konvergensi
K-means.
Apakah hasil dari setiap eksekusi
algoritma pada data yang sama adalah selalu sama? Jawabannya tidak.
Karena ada unsur random disini, maka ada kemungkinan algoritma akan
menghasilkan hasil yang berbeda-beda. Untuk memastikannya, biasanya
algoritma dieksekusi berulang kali, dan hasilnya dianalisa.
Penutup
Kita
sudah melihat bagaimana algoritma K-means dan model matematiknya.
Metode K-means adalah metode yang paling dasar dan paling populer dalam clustering.
Namun demikian, banyak sekali kekurangan dalam metode ini. Metode ini
biasanya dapat berjalan dengan baik ketika data yang sedang diproses
mempunyai model Gaussian. Kalau kita tidak tau model dari data yang kita punya, tidak usah takut karena biasanya dalam clustering
kita bisa mencoba-coba terus menerus baik itu mengubah nilai K, maupun
mengeksekusi algoritma berulang kali sampai kita puas dengan hasilnya.
Baca Selengkapnya...
Friday, November 30, 2012
Clustering vs Classification
Diambil dari http://pengolahancitra.com, bahasanya enak dibaca, saya edit sedikit biar komplit.
Pengantar
Pada artikel singkat ini, kita akan membahas mengenai perbedaan antara clustering dan classification. Adalah penting untuk mengetahui perbedaan antara keduanya. Karena keduanya membawa pada pendekatan dan solusi yang berbeda.
Clustering
Secara formal clustering di definisikan sebagai suatu proses unsupervised
untuk mengelompokan data yang memiliki karakteristik tertentu yang
sama.
Di Wikipedia, Cluster analysis atau clustering adalah pengelompokan object-object kedalam kelompok-kelompok (yang disebut cluster) sehingga object-object yang ada di dalam cluster yang sama lebih mirip satu dengan yang lain dibandingkan dengan cluster yang berbeda.
Sederhananya seperti ini. Misalkan kita diberikan kelompok data,
katakanlah data tinggi anak-anak pada sekolah SD. Katakanlah kita ingin
mengelompokkan data-data ini kedalam 3 kelompok yang mana setiap
kelompok memiliki tinggi yang kurang lebih sama. Problem tersebut dapat dikategorikan dalam clustering problem.
Ada banyak pendekatan yang ada dalam clustering. Salah satu yang paling terkenal adalah pendekatan k-means clustering.
huruf K yang ada pada K-means berarti kita mengasumsikan bahwa kita
mengetahui jumlah kelompok yang akan dihasilkan.
Sederhananya algoritma
ini adalah sebagai berikut. Kita asumsikan ada K kelompok. Katakanlah
ada 3 kelompok. Lalu, kita tentukan secara acak 3 cluster centre. Lalu kelompokkan data-data kedalam kelompok yang memiliki jarak terpendek antara data tersebut dengan cluster centre. Selanjutnya, kalkulasikan centre baru
pada setiap kelompok. Lakukan langkah tersebut hingga pusat kelompok
tidak berubah. Mudah bukan?
Bagaimana kalau saya tidak mempunyai informasi mengenai jumlah kelompok yang mungkin terjadi? Ada caranya! yaitu dengan memakai leader-follower algorithm. Sederhananya, pendekatan ini memakai graph theory. Pertama2x kita pilih satu data menjadi cluster representation, selanjutnya, diberikan data yang lain, kita hitung jarak antara data tersebut dengan cluster representation yang ada. Jika jaraknya terlalu besar, maka data tersebut akan dikelompokkan dalam cluster yang baru.
Dalam clustering, biasanya kita menghadapi jumlah data yang amat banyak. Nah! ada beberapa pendekatan, ada yang disebut offline clustering , ada yang disebut online clustering.
Offline clustering artinya pendekatan tersebut tidak dapat digunakan dalam aplikasi real-time, mungkin saja prosesnya membutuhkan waktu 1 hari. Sebaliknya online clustering
mungkin bisa memproses data dalam hitungan detik. Tentunya tidak ada
makan siang yang gratis. Kita harus mengorbankan beberapa hal untuk
mendapatkan keuntungan di hal yang lainnya.
Kalau diperhatikan, k-means clustering termasuk dalam offline clustering.
Ini disebabkan pada setiap iterasi pendekatan ini memproses semua
datanya. Jadi jika ada 1 juta data, setiap kali iterasi, ada 1 juta data
yang di proses. Jika dibutuhkan sekitar 500 000 iterasi, artinya
komputer akan memiliki beban sekitar 500 milyar komputasi.
Sebaliknya leader-follower algorithm dapat dikategorikan dalam online clustering.
Dalam pendekatan ini, data yang sudah dikelompokkan tidak perlu
diproses lagi. Dan dalam setiap iterasinya hanya akan memproses 1 data
saja. Jadi kalau ada 1 juta data, komputer hanya akan memiliki beban 1
juta komputasi.
Classification
Pendekatan yang ada dalam classification
Ringkasan sedikit
Baca Selengkapnya...
Classification
Berbeda dengan clustering, classification
memiliki tujuan untuk mengklasifikasikan suatu data ke dalam kelompok
kelas yang sudah ada.
Sebagai contoh, misalkan diberikan sekelompok
sampel darah orang. Kita sudah tau jumlah kelompok golongan darah. Maka
tugas kita hanyalah menentukan suatu sampel darah masuk ke kelompok
mana. Jadi intinya, tidak akan ada pembentukan kelompok baru. Dan
biasanya prosesnya supervised. Dalam arti ada training yang dilakukan, dan dalam training tersebut, kita diberikan sekelompok sampel darah yang sudah diketahui masuk ke kelompok manakah sampel tersebut.
Ada banyak! contohnya adalah neural network. Dalam pendekatan ini, neural network
dilatih dengan menggunakan data yang sudah diketahui masuk ke kelompok
mana data tersebut. Setelah pelatihan, prosesnya cukup sederhana, yaitu
dengan memasukkan data baru (yang tidak termasuk dalam data training) ke dalam neural network, lalu neural network akan memberikan informasi termasuk ke dalam kelompok manakah data baru tersebut.
Contoh lain adalah pendekatan K-nn (k nearest neighbour). Dalam hal ini setiap data baru akan dibandingkan dengan data training. Lalu 3 data training
terdekat (misalkan kita ambil k = 3) dengan data baru akan diambil.
Misalkan ketiga data tersebut masuk ke dalam kelompok 1, 2 dan 1, maka
data baru tersebut dimasukan ke dalam kelompok 1 (seperti voting, karena suara yang terbanyak adalah 1, maka keputusannya adalah 1).
Maka jelas, kalau clustering dipakai
ketika kita tidak mengetahui bagaimana data harus dikelompokkan. Kita
bisa mengasumsikan jumlah kelompok yang ada. Keluaran pendekatan ini
adalah data yang sudah dikelompokkan. Di lain pihak, dalam classification, kita sudah mempunyai informasi mengenai bagaimana data tersebut dikelompokkan. Tugas kita hanyalah melakukan training
pada sistem dengan data yang sudah diberikan label (ke dalam kelompok
manakah data tersebut dikelompokkan), selanjutnya sistem akan
mengklasifikasikan data-data yang baru ke dalam kelompok yang ada. Tidak
akan ada pertambahan kelompok.
Tuesday, November 20, 2012
Image Enhancement vs Image Restoration
Diambil dari http://pengolahancitra.com
Acapkali dalam menghadapi permasalahan di pengolahan citra, kita berhadapan dengan citra yang mempunyai pengotor (noise). Dalam proses, kita ingin menghilangkan pengotor-pengotor tersebut. Ada dua macam teknik yang kita dapat lakukan, yaitu image enhancement dan image restoration. Apakah berbedaannya? Marilah kita lihat satu persatu.
Apa itu pengotor?
Noise atau pengotor citra biasanya didapat dari proses dijitasi citra. Apa itu proses dijitasi citra? ini adalah proses meng-capture
objek di dunia nyata kedalam citra dijital. Bingung? Singkatnya, kalau
kita memotret sesuatu dengan kamera dijital, sebenarnya kita sedang
melakukan proses dijitasi citra. Nah... kadang-kadang lensa kamera kita
kotor kan? jadi ada bintik-bintik di foto yang didapat. Bintik-bintik
itu salah satu jenis pengotor. Sebenarnya ada banyak jenis pengotor.
Jenis-jenis pengotor ini akan dibahas pada artikel terpisah. Untuk
sementara, asumsikan bahwa pada proses "Pemotretan" (proses
dijitasi citra), ada banyak hal yang menyebabkan citra tidak sempurna
(memiliki pengotor). Oh ya, jenis pengotor yang lainnya adalah pengotor
yang berasal dari hardware (cth: kamera yang setengah rusak).
Image Restoration
Teknik ini dipakai pada saat kita dapat memodelkan pengotor.
Pengotor
dapat dimodelkan? Kenapa tidak?! Ada beberapa jenis pengotor yang dapat
kita modelkan, misalkan pengotor yang berasal dari sensor yang
kurang sempurna, pengotor yang berasal dari sinyal transmisi yang
kurang baik sehingga pada saat transimisi data citra tidak diterima
dengan baik. Salah satu contoh pengotor yang terkenal adalah salt-and-pepper noise (garam dan merica). Jenis pengotor ini didapatkan karena sensor yang kurang sempurna. Inilah salah satu contoh salt-and-pepper noise.


Perhatikan pada citra diatas, citra sebelah kiri adalah citra dengan pengotor salt-and-pepper, citra disebelah kanan adalah citra tanpa pengotor. Secara matematis, pengotor jenis ini dapat dimodelkan dengan memakai random variable yang ada pada ilmu probabilitas. Rumusnya adalah sebagai berikut.

Biasanya pengotor-pengotor dimodelkan secara matematis dengan menggunakan Probabilistic Density Function (PDF).
Kenapa? Karena, noise itu random bukan? maksudnya, tidak dapat diterka,
dimana dan kapan dia muncul. Namun demikian, kita dapat mengira-ngira
kemungkinan suatu pengotor itu muncul. Nah ilmu mengira-ngira
kemungkinan itu ada di ilmu probabilitas.
Lalu
setelah kita mengetahui jenis pengotornya. Apa yang kita lakukan
berikutnya? Wah gampang itu... biasanya kalau kita sudah tau jenis
pengotornya, dan kita tau kalau jenis pengotor tersebut dapat
dimodelkan. Hal berikutnya adalah mencari filter yang dapat menghilangkan noise tersebut. Contohnya, pada kasus salt-and-pepper noise , untuk menghilangkan noise tersebut secara sempurna adalah dengan menggunakan median filter. Dijamin mutu, pasti pengotornya akan hilang seketika.
Jadi esensi image restoration
adalah ketika kita dapat memodelkan pengotor, dan pengotor tersebut
sudah dikenal, kita tinggal menggunakan metode yang sudah ada untuk
menghilangkan pengotor. Dan biasanya hasil image restoration cukup memuaskan. Kebanyakan hasilnya adalah, kita mendapatkan citra tanpa pengotor tersebut.
Image Enhancement


Baca Selengkapnya...
Teknik ini dipakai pada saat kita tidak dapat memodelkan pengotor. Biasanya proses ini dilakukan secara heuristic, alias coba-coba sampai puas. Kalau pada proses image restoration kita tau kapan saatnya berhenti, pada image enhancement penilaian subjektif sangat berpengaruh. Proses ini baru berhenti ketika kita merasa puas akan hasil yang didapatkan.
Ada banyak metode yang dapat dipakai pada image enhancement. Metode tersebut sebagian besar adalah berupa filter. Filter-filter ini nantinya akan dikonvolusi dengan citra untuk mendapatkan hasil yang baik. Untuk proses filtering akan dibahas secara terpisah. Selain dengan menggunakan filter, ada metode-metode lain seperti transformasi, histogram, contrast-stretching, dan sebagainya. Contoh metode yang paling mudah adalah power-law transformation pada grey-level. Pada prinsipnya setiap nilai grey level pada pixel diganti dengan nilai hasil perhitungan formula tertentu. Bingung? Baik, marilah kita lihat formula power-law transformation ini.
n adalah nilai grey level yang baru, r adalah nilai
grey level yang lama, s dan a ditentukan sesuai dengan selera. Misalkan
pada koordinat (1,1), nilai grey-level untuk komponen red
adalah 120. Maka, dengan s = 1 dan a = 0.5 nilai ini akan diganti
menjadi 10.9. Kalau dilihat, proses ini akan membuat setiap nilai menuju
nilai 0, alias membuat citra lebih gelap!. Ingin membuat lebih terang?
Mudah, ubah a menjadi 1.2 alhasil, citra akan semakin terang.
Berikut ini adalah contoh dari power-law transformation.
Citra sebelah kiri adalah citra hasil power-law transformation
dengan nilai peubah a 1.2, sebelah kanan adalah dengan nilai peubah
0.5. Yang mana yang lebih baik? Itu tergantung kebutuhan. Mungkin ada
yang lebih memerlukan citra yang terang, atau mungkin ada yang lebih
membutuhkan citra yang lebih gelap.
Sebagai kesimpulan, kita dapat melihat perbedaan yang mendasar antara image restoration dan image enhancement. Image restoration
adalah proses yang pasti, dan menghasilkan citra yang baik. Biasanya
dapat dilakukan bila jenis pengotor dapat dimodelkan. Di lain pihak, image enhancement adalah
proses heuristik yang sangat bergantung dari kebutuhan dari setiap
kasus. Biasanya dipakai ketika pengotor tidak dapat dimodelkan.
Monday, October 15, 2012
Artificial Intelligence 1
Terminologi
Ada banyak istilah yang berkaitan dengan Artificial Intelligence ini, yaitu:
- Artificial Intelligence, sebuah program yang memungkinkan komputer berpikir seperti manusia dalam menyelesaikan suatu tugas. Program ini meliputi neural network, sistem feedback yang seperti otak yang memungkinkan komputer untuk belajar dan membentuk pengetahuan baru yang didapat dari pengalaman, serta expert system yang dapat memecahkan masalah menggunakan pengetahuan dan kemampuan manusia.
- Control System, merupakan bagian dari kehidupan kita sehari-hari, contoh: pemanas dan pendingin udara yang mengontrol temperatur ruangan agar kita merasa nyaman. Di dalam mobil perangkat seperti power steering, cruise control, dan automatic transmission menggunakan sistem kontrol. Air craft, automated manufacturing tools, dan self guided agricultural equipment menggunakan sistem kontrol agar tetap pada jalurnya dan menjalankan fungsi-fungsinya meskipun terjadi gangguan atau fluktuasi.
- Expert System, (ES) dapat memecahkan masalah menggunakan kemampuan dan pengetahuan manusia. Pengetahuan dan proses berpikir seorang pakar (expert) dikumpulkan dan diprogram dalam sebuah Knowledge Base. Melalui Knowledge Base, ES dapat menggantikan atau membantu para pakar lain dalam membuat keputusan yang kompleks dengan menggabungkan pengetahuan para pakar dan pengetahuan dalam Knowledge Base.
- Intelligence Control System, sistem kontrol yang cerdas. Sistem kontrol yang menggunakan metode AI dalam penyelesaian masalahnya sehingga lebih flexible.
- Microcontroller, sebuah microprocessor yang fungsi utamanya adalah untuk memantau dan mengontrol sebuah proses.
- Microprocessor, "jantung" (bagian inti) dari mesin atau komputer pemantau atau pengontrol.
- Neural Networks, pada manusia, neuron dalam otak membantu manusia mempelajari bagaimana membaca tulisan manusia, mengenali buah apple yang busuk dari sekeranjang buah apple atau mengidentifikasi anak mereka dalam sekelompok anak. Neural network (jaringan neural) pada komputer menggunakan prinsip yang sama dengan neuron pada otak manusia untuk mengenali dan mengelompokan pola-pola yang berbeda. Dapat dikatakan, neural network merupakan bentuk digital dari otak manusia.
- Telemetric Sensing Technology,microprocessor yang ditanam atau di-implant-kan kedalam tubuh hewan untuk mengukur temperatur tubuh dan respon fisiologis. Informasi yang dihasilkan kemudian diolah oleh komputer atau controller yang memantau atau mengontrol proses otomatis yang mempengaruhi hewan tersebut.
 |
| Contoh Neural Network |
References:
Baca Selengkapnya...
Arificial Intelligence 2
Definisi
 |
| Gambar dari evulee.file.wordpress.com |
Lebih lanjut, di dalam situs wikipedia dijelaskan bahwa sistem cerdas tersebut dibuat agar mesin dengan sistem tersebut dapat melakukan pekerjaan seperti yang dilakukan oleh manusia.
Pekerjaan-pekerjaan manusia seperti apakah yang sebaiknya dialihkan ke mesin dengan sistem cerdas? Tentunya pekerjaan-pekerjaan yang monoton yang menuntut tingkat akurasi yang tinggi, pekerjaan-pekerjaan yang berbahaya untuk dilakukan manusia, serta pekerjaan-pekerjaan yang berat lainnya. Contoh pekerjaan perakitan di industri mobil.
Video ini tentang Mercedes-Benz e-class production
dari youtube.com
Penggunaan mesin cerdas seperti robot tersebut tidak semata-mata menggantikan tenaga kerja manusia namun bertujuan:
- Meringankan pekerjaan manusia
- Meningkatkan dan menjamin kualitas produk
- Dari sisi produksi meningkatkan kecepatan, ketepatan dalam bekerja dan kuantitas hasil produksi
- Dari sisi konsumen meningkatkan kepuasan konsumen
Baca Selengkapnya...
Wednesday, October 3, 2012
Sejarah Game Technology 1
Apakah game technology itu?
Game technology atau teknologi permainan ini merupakan teknologi yang dikembangkan untuk menciptakan berbagai jenis permainan berbasis komputer.
Sebenarnya permainan yang dimainkan menggunakan komputer bukanlah sesuatu yang baru. Berikut sejarah perkembangan teknologi permainan.
Perkembangan game technology diawali pada tahun 1947. Pada saat itu Thomas T. Goldsmith Jr. dan Estle Ray Man menemukan Cathode Ray Tube amusement device. Perangkat permainan dengan menggunakan cathode ray tube ini merupakan game elektronik yang pertama.
 |
| Cathode Ray Tube Amusement Device |
 |
| Game Space War pada Cathode Ray Tube Amusement Device |
 |
| Game Space War |
Tombol kontrol (control knobs) - lihat gambar kedua - digunakan untuk mengubah lintasan dan sudut sinar yang ditampilkan pada monitor.
Pesawat dan benda-benda angkasa yang nampak ditampilkan secara transparan dan koordinat letaknya telah di program di dalam perangkat. Sinar yang ditampilkan dalam bentuk dot (titik) yang sesuai dengan letaknya. Pengguna harus menggerakan dot sehingga tumpang tindih dengan pesawat atau benda-benda angkasa, kemudian dengan menekan tombol kontrol, pengguna dapat menembakan rudal ke pesawat atau benda-benda angkasa tersebut.
Berikut cuplikan dari video cathode ray tube amusement device yang saya download dari youtube.com
Oleh Sutini Dharma Oetomo (Penerima Beasiswa Unggulan Kemendiknas Angkatan ke 6 Universitas Dian Nuswantoro)
Referensi:
History of video game; Wikipedia
Cathode Ray Tube Amusement Device; Game A2Z
Video cathode ray tube amusement device; Youtube.com
Baca Selengkapnya...
Monday, August 13, 2012
Industri games berpeluang untuk dikembangkan
Berita ini diambil dari situs: Game Technology Unika Soegijapranata
Mengapa Beasiswa Unggulan dari Kemendiknas di fokuskan pada Game Technology? Saya pikir berita dari Suara Merdeka ini dapat dijadikan salah satu sumber jawaban.

SEMARANG - Dukungan terhadap
industri kreatif di Indonesia tidak setengah-setengah. Telkom melalui
divisi multimedia juga membuka peluang bagi industri kreatif games untuk
masuk ke dalam unit bisnisnya.
Komang Budi
Aryasa, Senior Manager Content Incubation & Aggregation Support
Divisi Multimedia Telkom Indonesia dalam Seminar Masa Depan Teknologi
dan Bisnis Games di Unika Soegijapranata menyatakan, Telkom siap
memfasilitas pengembang games Indonesia melalui strategi yang
dikembangkan beberapa tahun terakhir ini.
”Dengan
sistem bagi hasil dari Telkom, pengembang games bisa mendapatkan bagian
20% dari hasil penjualan. Namun harus diakui, perlu edukasi dan
pendekatan yang konsisten agar developer games tumbuh di Indonesia,”
katanya Selasa (22/5).
Di sisi swasta, program
game technology di Unika Soegiapranata merupakan angin segar bagi masa
depan pengembangan games di Indonesia. Bukan hanya mengisi peluang
programmer games, tetapi juga menciptakan potensi lapangan kerja.
Ketua
Panitia Festival Games & Entrepreneur 2012 Bernardinus Harnadi
menyatakan, seminar ini satu rangkaian dengan turnamen DotA yang
diadakan 20-21 Mei dan didukung Beasiswa Unggulan Kementerian Pendidikan
dan Kebudayaan.
Faktor Stimulan
Tutorial
pembuatan games secara mudah oleh Erdhi Widyarto dari Game Technology
Unika, menunjukkan bahwa imajinasi merupakan salah satu faktor yang
dapat menstimulasi perkembangan industri ini.
Pembicara lainnya, Christine Wibhowo juga memaparkan games dapat menstimulasi kecerdasan anak dan remaja.
Rektor
Unika Prof Dr Y Budi Widianarko MSi menyerahkan beasiswa unggulan
kepada wakil mahasiswa yang menerima. Dengan beasiswa itu, pemerintah
membuka peluang bagi anak bangsa untuk berkembang dalam industri kreatif
games lokal maupun global. (D9-37)

Subscribe to:
Posts (Atom)